
Комплексный коммерческий дизайн — соц. сети, маркетплейсы, портфолио
LLaDA-Image: новая открытая AI-модель для генерации и редактирования изображений
4 сентября 2026 года в открытый доступ вышла LLaDA-Image — новая AI-модель от команды Inclusion AI для генерации и редактирования изображений. Проект интересен не только качеством получаемых картинок: разработчики опубликовали веса модели, inference-код и подробное описание процесса обучения.
Главная особенность LLaDA-Image — возможность использовать одну модель сразу для двух задач: создания изображения с нуля и редактирования уже существующего изображения по текстовой инструкции.
Для дизайнеров это особенно интересно. Модель можно использовать для создания концептов, визуальных референсов, постеров, рекламных материалов и вариантов существующих изображений, причём запуск возможен локально.
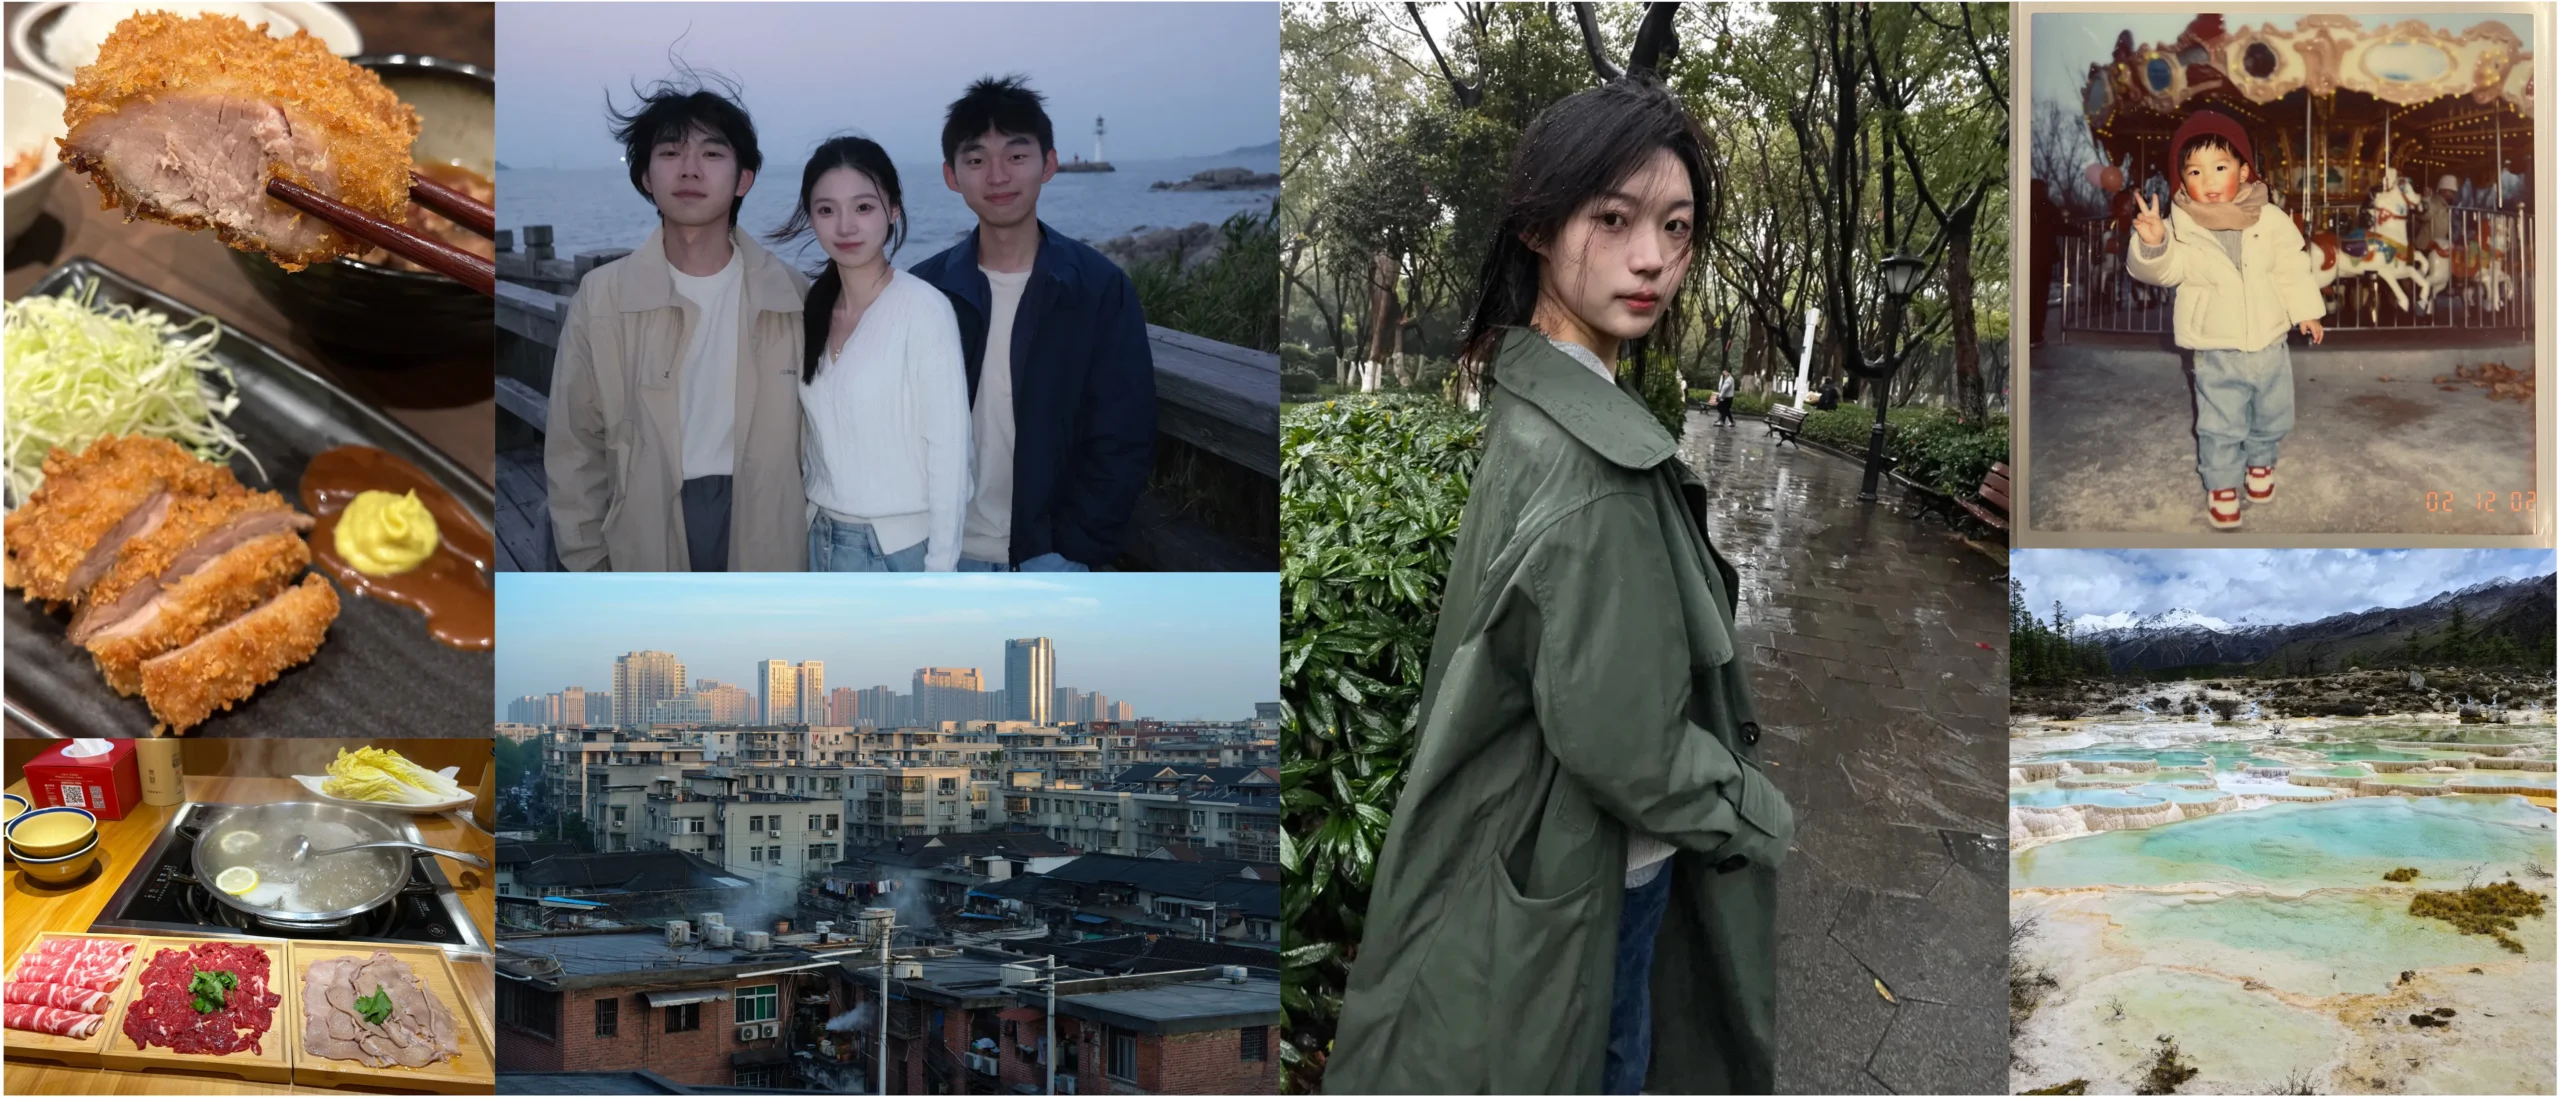
«Photorealistic image generation with natural lighting, lifelike details, and coherent scenes.»
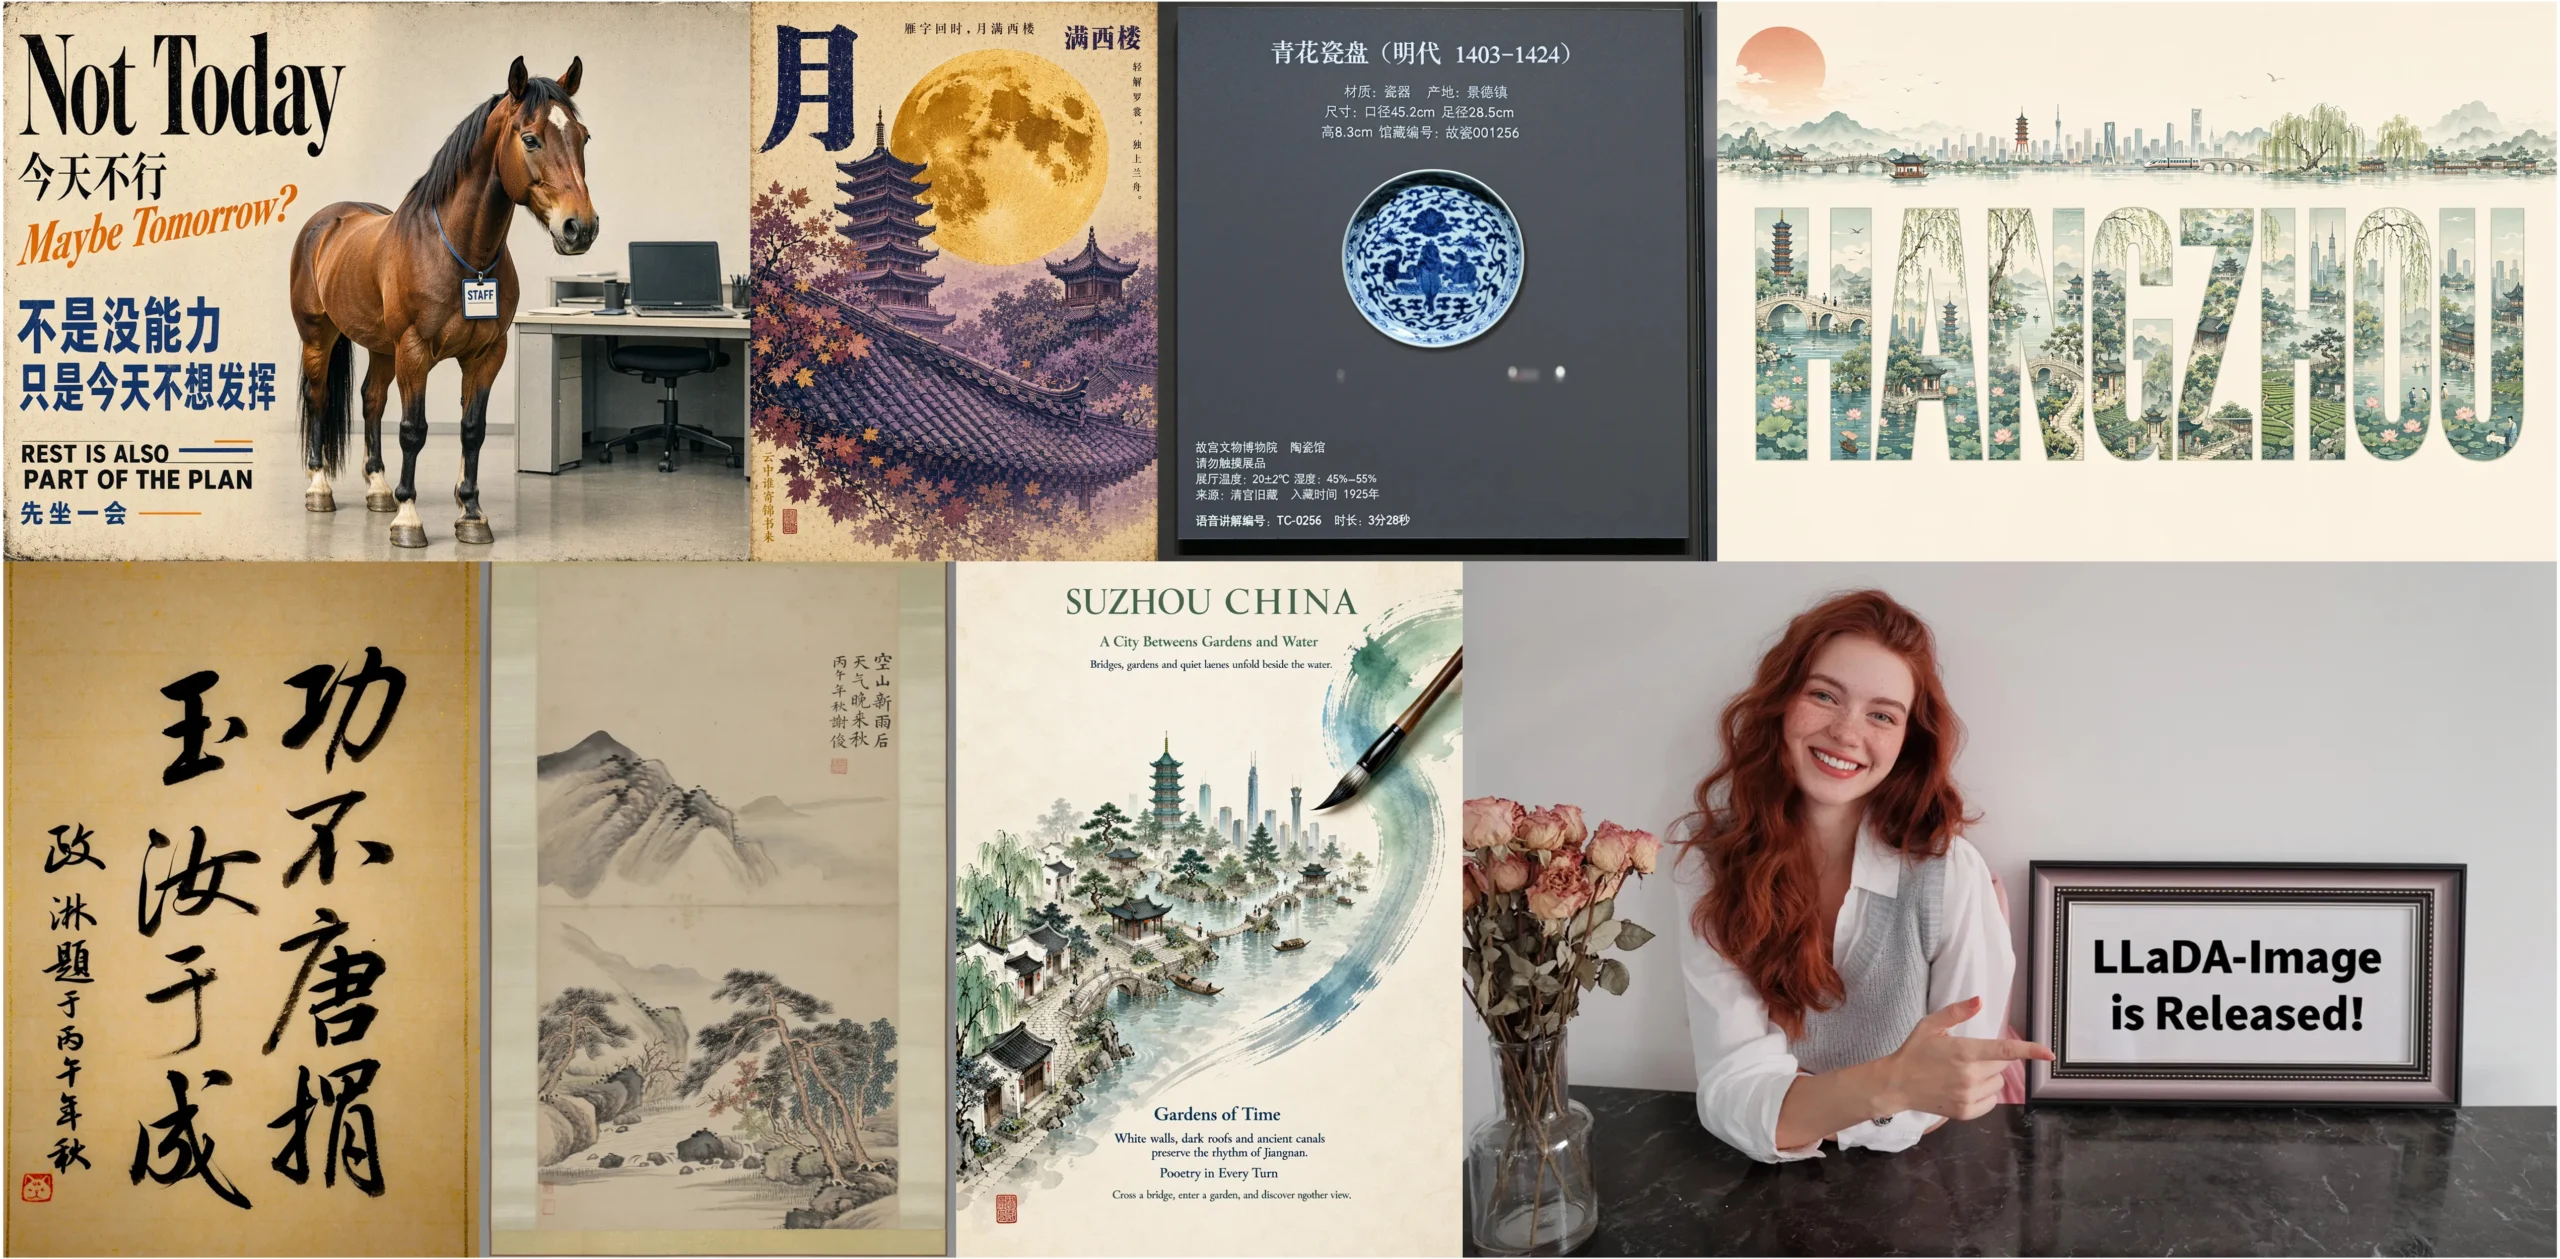
«High-quality text rendering and creative poster generation across diverse visual styles.»
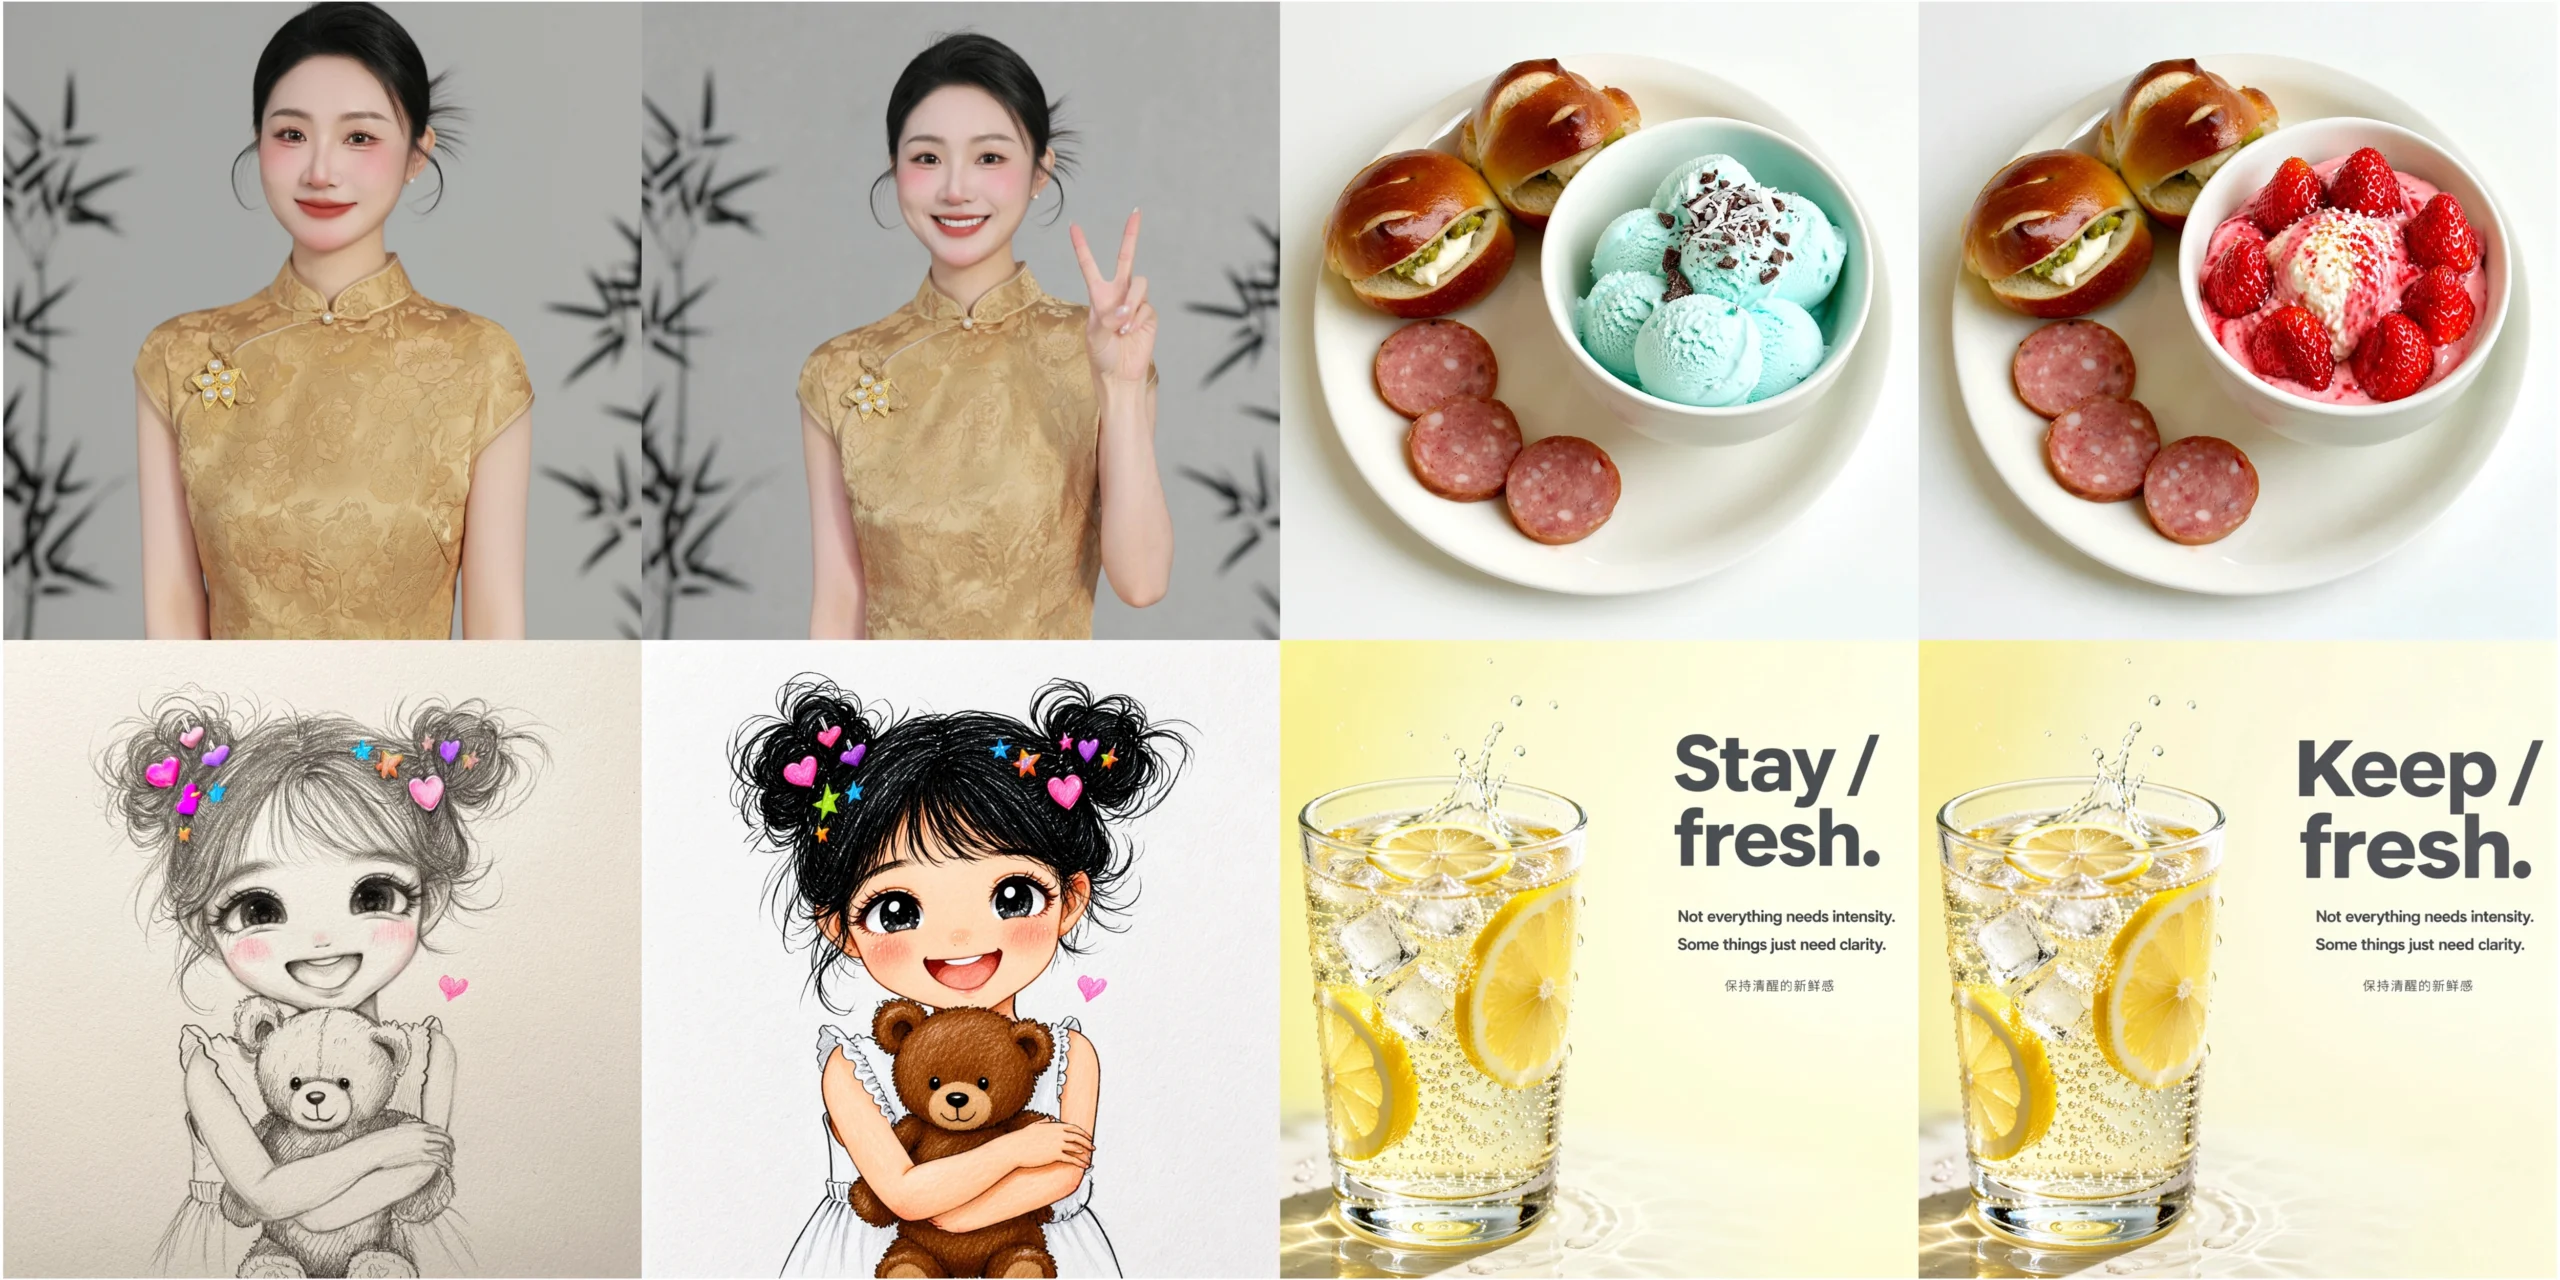
«Instruction-guided image editing with faithful content preservation and precise visual changes.»
Что такое LLaDA-Image
LLaDA-Image — открытая AI-модель с 6 млрд параметров, построенная на архитектуре Diffusion Transformer (DiT).
Модель использует diffusion language model backbone из семейства LLaDA2.0 и предназначена для работы не только с генерацией, но и с редактированием изображений.
Обычный сценарий знаком большинству пользователей AI-генераторов:
текстовый промпт → готовое изображение.
LLaDA-Image добавляет второй сценарий:
исходное изображение + текстовая инструкция → отредактированное изображение.
В официальной документации разработчики отдельно указывают сохранение структуры, деталей, текстур и фона при редактировании.
Модель поддерживает:
- text-to-image;
- редактирование изображений по инструкции;
- генерацию с VQ-условием;
- работу с reference image;
- генерацию текста внутри изображений;
- английский и китайский языки.
Таким образом, LLaDA-Image рассчитана не только на создание изображений «с нуля», но и на более практические задачи визуального производства.
Почему LLaDA-Image
Исследовательская работа LLaDA-Image: Building Strong Image Generators with Fully Open Training Recipes была опубликована на arXiv 3 сентября 2026 года. Уже 4 сентября команда Inclusion AI объявила о публикации Base и Turbo-моделей и inference-кода.
Особенность проекта заключается в том, что разработчики раскрывают значительно больше деталей, чем многие закрытые AI-системы.
В исследовании описаны архитектура модели, используемые данные, процесс обучения, методы генерации и ускорения.
Для обучения генеративной части использовалось около 220 млн образцов, из которых 98% составляют реальные изображения. Более 90% данных относятся к image-only данным.
Именно открытость проекта делает LLaDA-Image особенно интересной для AI-сообщества: речь идёт не просто о новом онлайн-генераторе, а о модели, которую можно изучать, запускать и интегрировать в собственные инструменты.
LLaDA-Image Base и Turbo
На старте опубликованы две основные версии модели.
LLaDA-Image Base
Основная версия предназначена для генерации и редактирования с использованием 50 шагов сэмплирования в рекомендованной конфигурации.
Она рассчитана на сценарии, где приоритетом является качество результата.
LLaDA-Image Turbo
Turbo — ускоренная версия модели, созданная с использованием дистилляции.
Вместо десятков шагов она работает всего за 4 шага в официальном примере.
Это особенно полезно для дизайна, где требуется быстро получить большое количество вариантов.
Например:
- несколько вариантов постера;
- разные визуальные концепции;
- варианты рекламного креатива;
- серия изображений для соцсетей;
- быстрый поиск композиции;
- визуальные референсы.
При этом обе версии предназначены как для генерации, так и для редактирования изображений.
Как использовать LLaDA-Image в дизайне
Создание визуальных концепций
LLaDA-Image можно использовать на раннем этапе разработки визуального решения.
Например, текстовое описание может задавать композицию, настроение, стиль, освещение и свободное пространство под будущую типографику.
Это позволяет быстро получить несколько направлений ещё до начала полноценной работы в графическом редакторе.
Редактирование готового изображения
LLaDA-Image поддерживает instruction-based editing — редактирование изображения с помощью текстовой команды.
В официальном репозитории приведён пример преобразования исходного изображения в акварельную иллюстрацию. Исходное изображение передаётся модели как reference image, после чего задаётся текстовая инструкция.
Практически такой подход можно использовать для задач вроде:
«Замени фон на современный интерьер, сохрани основной объект и его композицию».
Или:
«Сделай изображение в стиле акварельной иллюстрации, сохранив композицию».
Или:
«Добавь мягкое студийное освещение, сохранив объект и его пропорции».
Это уже гораздо ближе к реальному дизайнерскому workflow, чем простая генерация изображения по описанию.
Самая интересная часть проекта для дизайнеров — не генерация очередной красивой картинки, а возможность работать с уже существующим изображением.
Генерация текста внутри изображения
Отдельного внимания заслуживает работа с текстом.
Разработчики LLaDA-Image заявляют поддержку качественного рендеринга текста и демонстрируют генерацию креативных постеров.
Это важно для дизайна, поскольку текст внутри AI-генераций долгое время оставался одной из наиболее проблемных областей.
Модель поддерживает английский и китайский языки. При этом официальная документация не заявляет русский язык как отдельный поддерживаемый язык для генерации текста внутри изображения.
Поэтому для русскоязычной типографики надёжнее по-прежнему рассчитывать на последующую работу в Figma, Photoshop или другом графическом редакторе.
Насколько хорошо работает LLaDA-Image
У проекта есть достаточно сильные результаты на собственных тестах.
На Qwen-Image-Bench LLaDA-Image получила:
- 53,53 на английском треке;
- 53,38 на китайском треке.
Авторы исследования называют эти результаты state-of-the-art среди open-source моделей на обоих треках.
Однако эту цифру не стоит интерпретировать как доказательство того, что LLaDA-Image превосходит абсолютно все современные генераторы изображений.
Benchmark отражает конкретную методику тестирования, а сравнения в исследовательской работе проводились авторами проекта.
Корректнее говорить, что LLaDA-Image демонстрирует очень сильные результаты среди открытых моделей и претендует на конкурентную позицию в современной генерации изображений.
Системные требования. Как запустить LLaDA-Image
Официальный репозиторий содержит готовый inference-код для локального запуска.
Для локального запуска LLaDA-Image официальная инструкция рекомендует:
- Python 3.11
- PyTorch 2.8
- Transformers 4.57.6
- Diffusers 0.39.0
- NVIDIA GPU с поддержкой CUDA
- для официального примера используется bfloat16
- базовое разрешение генерации — 1024×1024.
Разработчики не указывают конкретный минимальный объём VRAM, поэтому утверждать, что для запуска обязательно требуется 24 или 32 ГБ видеопамяти, некорректно.
Для пользователей без подходящего локального GPU существуют варианты запуска через облачные среды и публичные интерфейсы, а экосистема вокруг модели постепенно расширяется.
LLaDA-Image действительно открытая?
Здесь есть важный нюанс.
Проект позиционируется как открытый и действительно предоставляет веса и inference-код. Модели на Hugging Face распространяются по лицензии Apache 2.0.
Однако на официальной странице GitHub в разделе Open Source Plan часть training code на момент подготовки материала всё ещё обозначена как coming soon.
Поэтому корректнее говорить, что веса и код для inference уже доступны, а не утверждать, что абсолютно весь исходный код проекта уже опубликован.
При этом исследовательская работа содержит подробное описание training recipe и процесса обучения.
Что это значит для дизайнер
LLaDA-Image интересна не потому, что появился ещё один генератор изображений.
Главное здесь — сочетание нескольких возможностей в одном открытом проекте:
6 млрд параметров + генерация + редактирование + reference image + генерация текста + локальный запуск + Turbo за 4 шага.
Такой набор постепенно превращает AI-модель из отдельного инструмента для создания картинок в часть полноценного дизайнерского процесса.
Возможный workflow выглядит следующим образом:
концепция → генерация → выбор варианта → редактирование текстовой инструкцией → создание нескольких версий → финальная работа в графическом редакторе.
Именно возможность работать с исходным изображением делает LLaDA-Image особенно интересной для профессионального дизайна.
Пока проект только появился в открытом доступе, поэтому его экосистема ещё находится в стадии активного развития. Следующим важным этапом станет появление большего количества готовых интерфейсов, интеграций и workflow.
Для дизайнеров это означает простую вещь: LLaDA-Image уже можно пробовать сейчас, а следить за развитием проекта особенно интересно именно из-за его открытой архитектуры и возможности локального использования.
А если необходим Дизайн карточек для маркетплейсов — Подробнее об услуге "Дизайн карточек".
Для ваших соц. сетей/каналов/шоу — Оформление каналов / сообществ и Обложки / превью для видео.
Коммерческий дизайн для брендов — Заказать логотип и айдентику.
Для любых идей и проектов — Иллюстрации на заказ. Дизайн обложек для трека и альбома.
Другие похожие статьи:
О сайте
Индивидуальный коммерческий дизайн «под ключ» — соц, сети, уникальные обложки, маркетплейсы и портфолио.
© Copyrights, 2026. Все права защищены